에이전트 데모는 늘 인상적이다. 문제는 데모가 끝난 다음이다. 팀에 에이전트를 붙이고 나면 가장 먼저 받는 질문이 '이거 얼마야?'인데, 놀랍게도 대부분의 팀 리드가 이 질문에 정확히 답하지 못한다. 추정치만 있고, 실측치가 없다. 그게 진짜 문제다.
최근 세 가지 사례가 이 문제를 동시에 건드렸다. AI 에이전트를 1,200회 실행해서 $1.20 청구서를 공개한 개발자, 엔비디아가 공개한 모델 라우팅 라이브러리 NeMo Switchyard, 그리고 Cursor MCP를 통한 영구 메모리 통합 이슈다. 각각을 따로 보면 흥미로운 뉴스지만, 묶어서 보면 AI-First 팀 리드가 지금 당장 설계해야 할 측정 구조가 보인다.
첫 번째: 콜 횟수를 직접 세라
dev.to에 올라온 사례 하나. 개발자가 n8n 기반 서포트 에이전트를 만들어 동일한 12개 티켓 인박스를 100회 반복 실행했다. 총 1,200회 모델 콜. 청구서는 $1.20. 티켓 한 장당 0.1센트다. 이걸 월 단위로 환산하면 티켓 1,000건에 약 $1, n8n 셀프호스팅 서버 비용 약 $4를 더해도 월 $5 수준이다.
비교 기준도 제시했다. 시장 1위 AI 고객지원 플랫폼인 Intercom Fin의 공개 가격은 건당 $0.99. 그 안에서 실제 모델 호출 비용이 차지하는 몫은 0.1센트. 나머지 98.9센트는 인박스, 라우팅, 분석, 컴플라이언스—플랫폼 패키징 비용이다. 이걸 아는 것과 모르는 것은 벤더 선택 협상력에서 완전히 다른 출발점이 된다.
이 사례가 던지는 핵심 메시지는 단순하다. "추정하지 말고 측정하라." 방법도 어렵지 않다. 프로바이더 응답 헤더에서 과금 단위를 읽고(x-fal-billable-units 같은 헤더), 루프로 감싸서 실행하고, 콜 수에 단가를 곱하면 된다. 프라이싱 페이지에 나온 숫자가 아니라 본인 워크로드로 뽑은 숫자가 있어야 한다.
두 번째: 일관성을 비용만큼 측정하라
같은 사례에서 더 중요한 발견이 나왔다. 1,200회 실행 중 98회는 동일한 판정을 냈다—9건 자동 응답, 3건 에스컬레이션, 매번 같은 티켓. 차이가 난 2회는 더 조심스러운 방향이었다. 에스컬레이션이 하나 더 늘었다.
이 숫자가 왜 중요하냐면, 저렴해도 비결정론적이면 장애나 다름없기 때문이다. 에이전트가 같은 입력에 다른 판단을 내리면 그건 비용 문제가 아니라 신뢰 문제다. 팀 리드가 에이전트를 프로덕션에 붙이기 전에 반드시 답해야 할 질문이 여기 있다: "이 에이전트는 같은 상황에서 같은 결정을 내리는가?"
이 일관성을 담보한 구조적 장치가 흥미롭다. 모델의 답변은 '투표'로만 취급하고, 실제 판정은 결정론적 코드가 내린다. 인용 없이 답변하면 자동 에스컬레이션. 모델이 확신해도 인용 근거가 없으면 통과 안 된다. 이 게이트가 일관성을 만든다. AI가 생성한 결과를 곧바로 행동으로 이어붙이지 않고, 검증 레이어를 끼워 넣는 설계다.
세 번째: 컨텍스트 비용은 별도로 계산하라
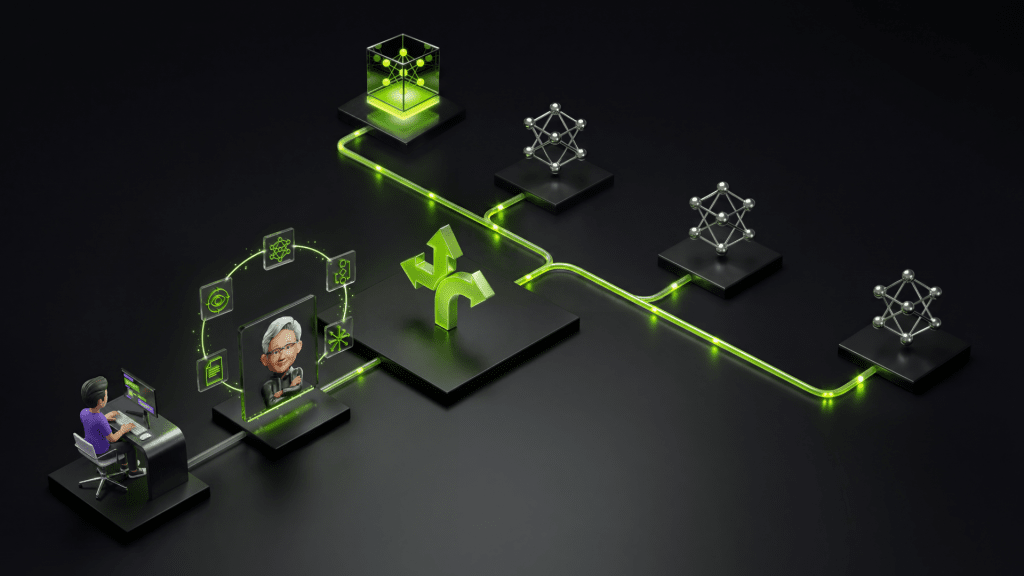
엔비디아가 공개한 NeMo Switchyard는 이 문제를 인프라 수준에서 정면으로 다룬다. 모든 에이전트 요청을 동일한 프런티어 모델로 보내는 게 아니라, 작업 복잡도·현재 상태·예상 토큰 수·응답 지연시간을 실시간으로 분석해서 그 순간 가장 비용 효율적인 모델로 라우팅한다.
결과가 인상적이다. LangChain이 145개 다단계 에이전트 작업으로 평가한 결과, Nemotron 3.5 Lightning과 Claude Opus를 에스컬레이션 라우터로 조합했을 때 프런티어 모델 단독 대비 비용이 74% 줄었다. 프런티어 모델로 넘어간 호출은 전체의 7%에 불과했다. 93%는 경량 모델이 충분히 처리했다는 뜻이다.
핵심 개념은 '작업 단계별 모델 수준'이다. 코드 작성 초반 탐색이나 반복 오류 수정에는 고성능 모델이 필요할 수 있지만, 테스트 완료 후 단순 반복 수정에는 경량 모델로 충분하다. Switchyard는 이 동적 변화를 실시간으로 추적한다. 오류가 쌓이면 자동으로 더 강한 모델로 올리고, 작업이 단순해지면 다시 내린다.
팀 리드 입장에서 Switchyard가 제공하는 가장 실용적인 기능은 로깅이다. 라우팅 결과, 선택된 모델, 판단 근거, 토큰 수, 지연시간, 호출 결과가 모두 기록된다. 이게 없으면 '왜 비용이 이만큼 나왔는가'를 역추적할 수 없다. 오픈소스로 공개됐고, OpenAI·Anthropic API 형식을 모두 지원한다.
Cursor MCP 영구 메모리 이슈도 같은 맥락에서 읽혀야 한다. Cursor는 세션이 끊기면 이전 컨텍스트를 잃는다. 어제 합의한 아키텍처 결정, 건드리지 않기로 한 레거시 모듈, 팀 코딩 컨벤션—다 사라진다. 이걸 MCP로 연결된 메모리 서버(로컬 파일 기반이든 관리형 서비스든)로 보완하면 에이전트가 세션마다 재학습하는 낭비를 줄일 수 있다.
그런데 이게 공짜가 아니다. 메모리 서버로의 읽기/쓰기는 추가 도구 호출이고, 관리형 서비스는 네트워크 홉이 붙는다. 로컬 서버라면 조회 지연이 낮지만 기기 간 동기화가 문제가 된다. 여기서도 측정이 필요하다. 컨텍스트 재입력에 드는 토큰 비용과 메모리 서버 유지 비용을 비교해서 어떤 게 더 비싼지 팀 상황에 맞게 계산해야 한다.
측정 구조를 먼저 설계하라
세 사례를 묶으면 실무 지침이 나온다.
1. 콜 횟수 계측 파이프라인부터 만들어라. 에이전트를 도입하기 전에, 모든 모델 호출을 로깅하고 비용을 집계하는 구조를 먼저 짠다. 나중에 붙이려면 훨씬 복잡해진다.
2. 일관성 테스트를 정기적으로 돌려라. 같은 입력 셋을 주기적으로 반복 실행해서 판정 일치율을 측정한다. 이 숫자가 떨어지기 시작하면 모델 업데이트나 프롬프트 변경이 일관성을 깨뜨렸다는 신호다.
3. 모델 라우팅을 단일 모델 고정으로 시작하지 마라. 처음부터 라우팅 레이어를 고려한 아키텍처를 설계해야 나중에 NeMo Switchyard 같은 도구를 끼워 넣기 쉽다. 단일 모델 고정으로 시작하면 최적화할 때 전체 파이프라인을 다시 뜯어야 한다.
에이전트 비용의 대부분은 보이지 않는 곳에서 쌓인다. 컨텍스트 재로딩, 불필요한 고성능 모델 호출, 비결정론적 판정으로 인한 재실행. 이걸 측정하지 않으면 줄일 수도 없다. 팀 리드가 먼저 수치를 들고 있어야 팀이 올바른 방향으로 최적화할 수 있다.